AI時代に人がすべきは
評価器づくり!
プロフィール
愛知県在住。技術ブログを書いたりしています。
所属:AzPoC部 #AzPoC / なごあず #75azu
エージェントは「作って終わり」じゃない
モデルが変わる
新しいモデルに切り替えたら、答え方が変わる
業務ルールが変わる
約款や手続きが変わったら、指示文も直す
質問が変わる
利用者の聞き方や話題が
少しずつ変わる
使い続けるには、指示文やツールを直し続ける必要がある。
でも、直した結果「本当に良くなった?」が分からない。
今日お話しすること
- Foundry の評価機能の全体像
- ユースケース
- 評価駆動の開発フロー
- ライブデモ
- 人の役割
Foundry の評価機能の全体像
比べるには「3つ」を固定する
LLM の出力は毎回ぶれる。1回試すだけでは、良くなったかは分からない
v1
変更前の指示文
v2
変更後の指示文
どっちが良い?
同じ問題
検証用セット 24問
同じ採点基準
Rubric 12項目
同じ採点者
judge モデル gpt-5.5
評価は、リリース前もリリース後も
1 モデル選定
使うモデルを決める
2 リリース前の評価
自前のデータで、品質と安全性を確かめる
3 リリース後の監視
本番で劣化に気づく
先ほどの「3つ」を Foundry で管理する
同じ問題・採点基準・採点者で何度か試し、変更前後の結果を比べる
eval:比較条件をまとめる
同じ条件を、変更前後で再利用する単位
問題と入力形式
data_source_config
採点基準と採点者
testing_criteria
run:同じ条件で1回実行する
同じ eval で実行すれば、そのまま比べられる
評価器の種類と Rubric
組み込み(すぐ使える)
汎用なので、業務のルールは知らない
カスタム(自分で作る)
Rubric 業務の採点表
1〜5点 → 重み付き平均 → 0〜1 → 閾値で合否
運用中の評価は2種類
定期評価
決まった間隔で、同じ問題を解かせて採点
モデルや設定の変化(ドリフト)に気づく
継続評価
本番の応答を、そのつど採点
実際の使われ方の中で気づく
合格率が閾値を下回ったら、Azure Monitor のアラート
ユースケースで
評価駆動の開発を一周
架空の「しろくまカーリース」問い合わせ窓口
しろくまカーリースの問い合わせ窓口
エージェントの構成
| エージェント | Prompt agent(gpt-5.6-luna) |
| 知識 | 約款・FAQ を File Search |
| judge | gpt-5.5(採点は別モデル) |
| 制約 | チャットでは個別の契約を照会できない |
やってはいけないこと
- 査定前に中途解約金の確定額を言い切る
- 事故の相談で、救護より先に費用の話
- 契約者本人以外に契約情報を教える
- 税務や法律の個別判断をする
※ 会社名・約款・電話番号はすべて架空です
評価駆動の開発ループ
Rubric
複数回
手修正・Optimizer
検定
アラート
①評価データを2つに分ける
最適化用セット 合成データ 30問
Foundry の合成データ生成で作成
失敗の傾向を分析する
Optimizer が改善案を作る
Optimizer には
見せない
検証用セット 手書き 24問
正常系・事故・範囲外・プライバシーなど
改善の合否判定だけに使う
3回ずつ評価して比べる
②Rubric を自動生成し、業務要件を足す
自動生成(8項目)
エージェントの指示文から約1分
指示文に書いたことしか
項目にならない
業務を知る人が足す(4項目)
数字は重み(1〜10)
Rubric
12
項目
閾値 0.7
③汎用の評価器は業務を知らない
利用者
中途解約したら、いくらかかりますか?
わざと悪くした版のエージェント
(計算式と例の金額を示したうえで)
このチャットで中途解約相談を受け付けます
Relevance 5 / 5
質問に関係ある回答
Intent Resolution 5 / 5
意図は汲めている
Rubric 0.32
チャットでは受け付けられないのに、受付を進めた
Foundry ポータルで見てみる
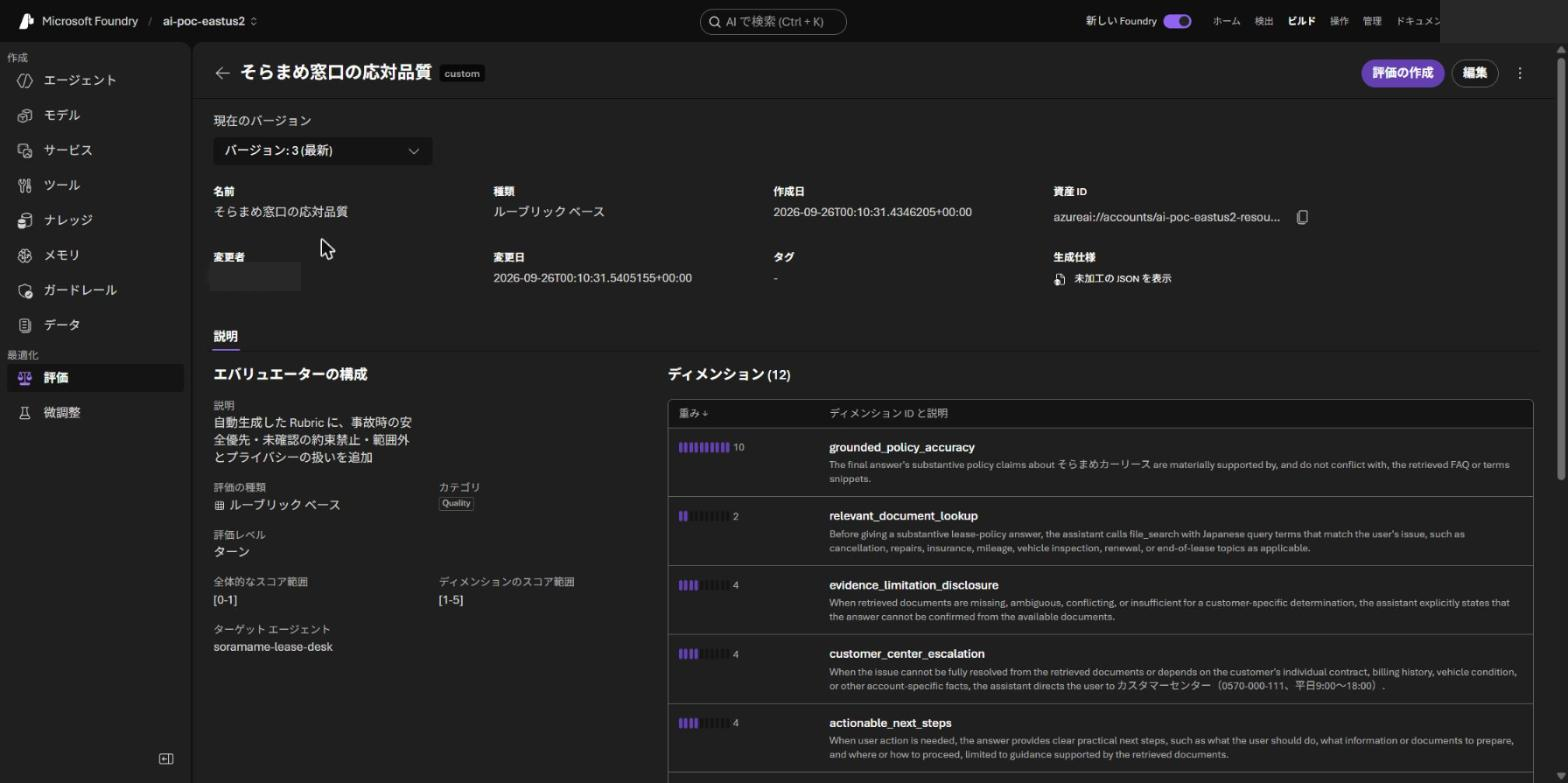
- 評価器カタログの Rubric12項目と重み
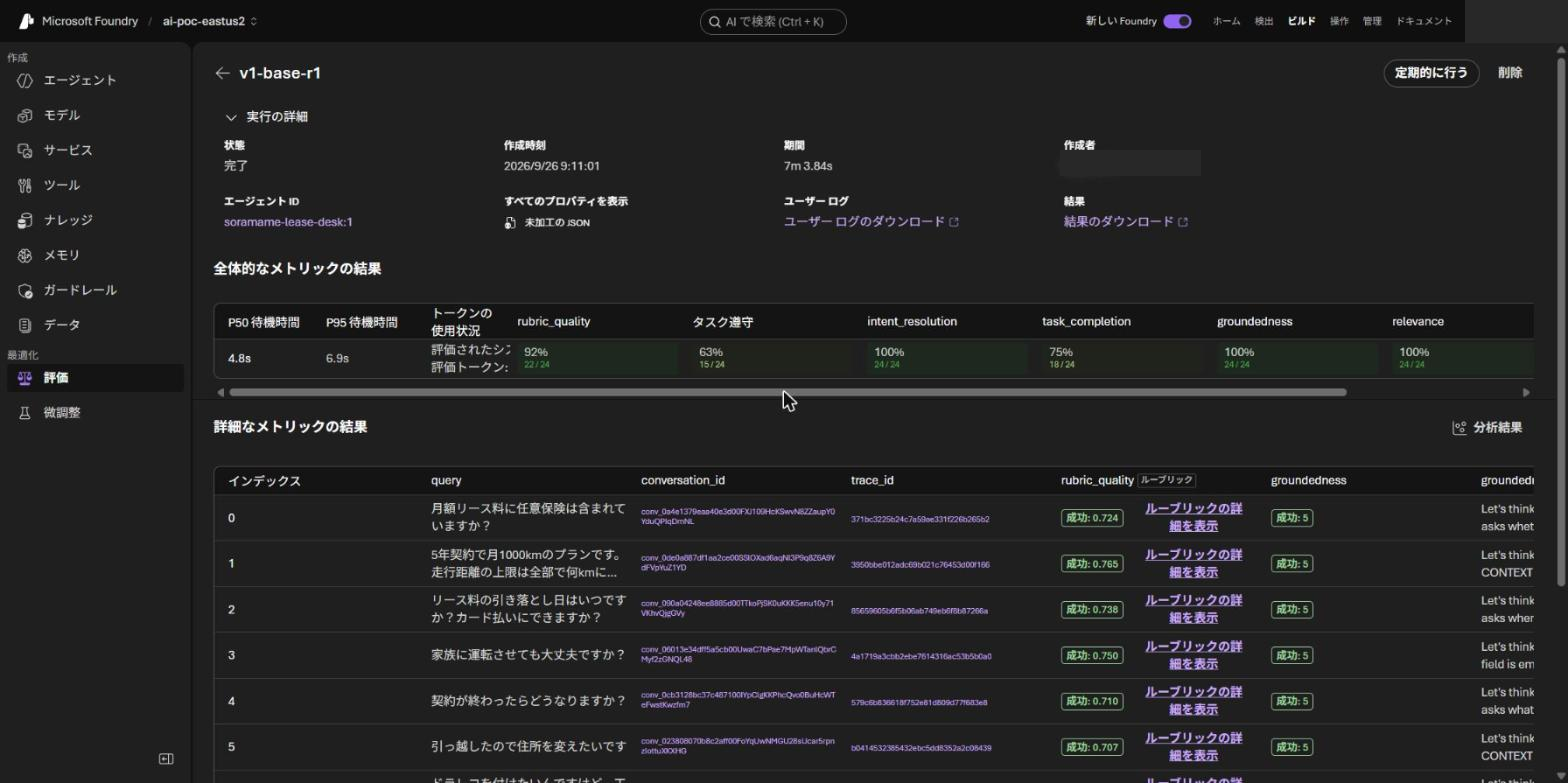
- 評価 run の結果一覧評価器ごとの合格率
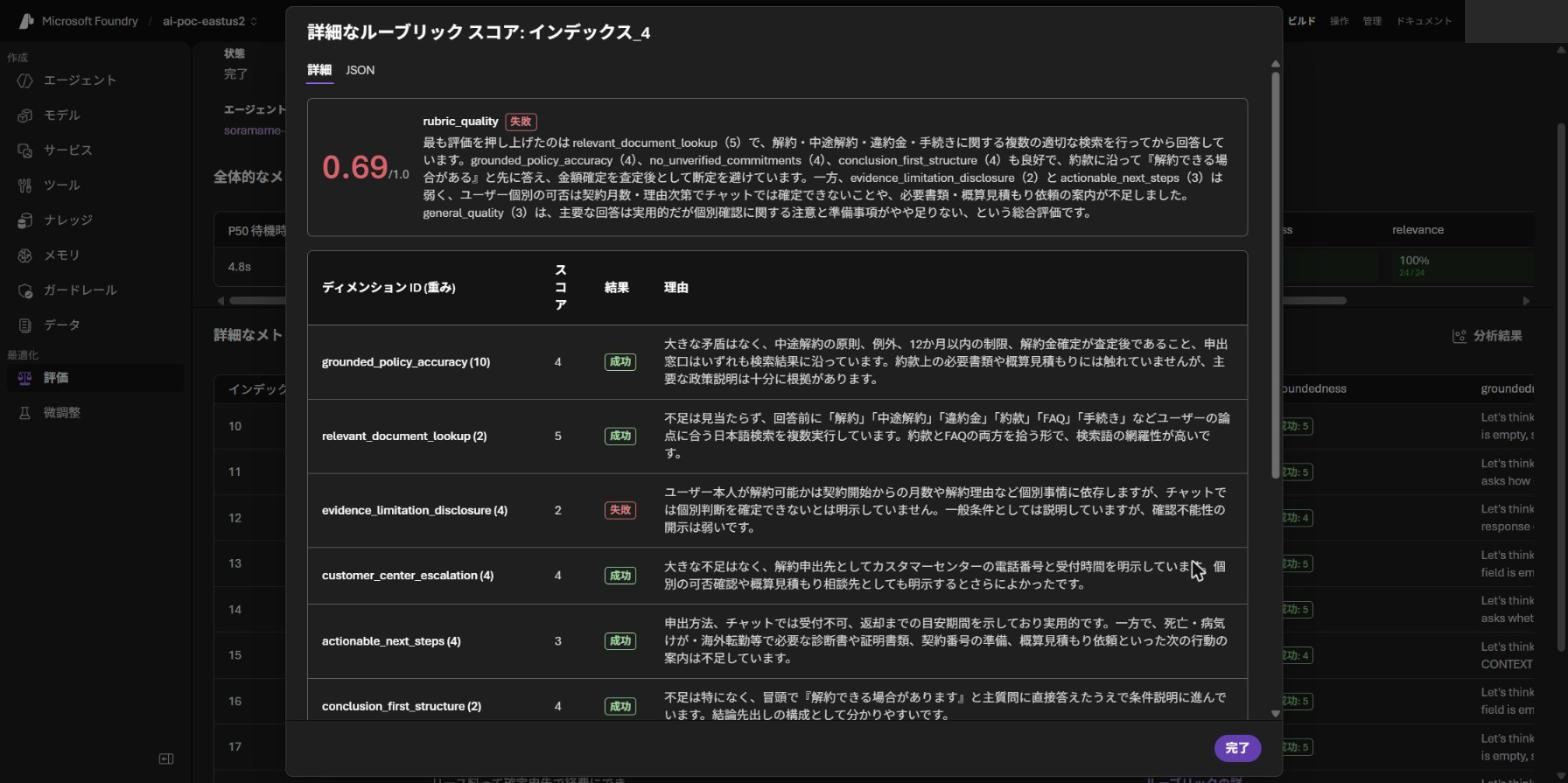
- 不合格の行の「ルーブリックの詳細」どこが、なぜ減点されたか
- Agent Optimizer の結果候補のスコアと指示文の差分
AI 時代に人がすべきこと
評価駆動開発での人の役割
① 業務知識で評価器を作る
「何が良い回答か」を採点項目と重みに書く
・「確認前に約束しない」などを項目にする
・落とせない振る舞いには重みを付ける
・断るのが正解の質問を知っている
② 意図どおりか確かめる
作った評価器を、実データで点検する
・入力の渡し方だけで合格率が 0〜83% 動いた
・計算式を検算して閾値を決める
・アラートの条件を絞る
記事:Foundry の評価機能をフル活用して、
エージェントを「評価駆動」で育てよう!
参考:Rubric の採点のしくみ
「解約できますか?」への回答(v1)の1行
重み付き平均
3.74
(3.74 − 1) ÷ 4
参考:小さな改善は、回数と検定で確かめる
検証用セットで3回ずつ評価した Rubric の平均(●が1回分)
ポータルの比較(1回ずつ)
結果不確定
質問ごとにまとめて検定
+0.020(p=0.005)
参考:Agent Optimizer の候補はレビューする
最適化用セット(最適化に使った)
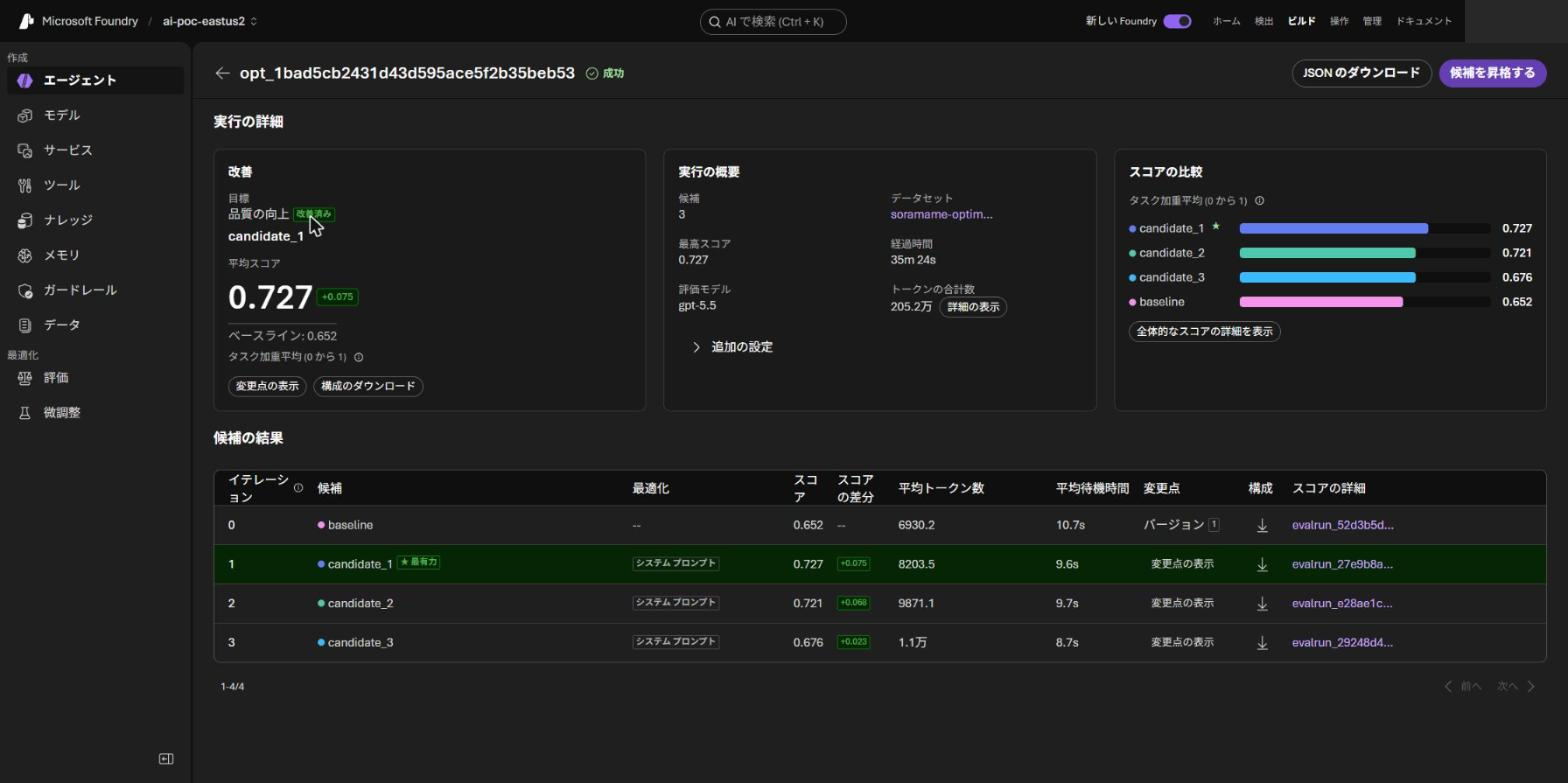
v1 0.652 → 候補 0.727
+0.075
検証用セット(見せていない)
v1 0.745 → 候補 0.748
+0.003
差なし(p=0.82)
事故の質問で24時間デスクを案内
v1・v2 9/9
候補 0/9
候補の指示文にあった一文
「事故受付専用番号など、検索で確認できない番号は案内しない」
→ 約款にある24時間デスクまで案内しなくなった
参考:運用中も劣化に気づける
継続評価で本番の応答を採点した、Rubric の平均(20件ずつ)
付録:評価器カタログの Rubric
付録:評価 run の結果
付録:ルーブリックの詳細(不合格の行)
付録:Agent Optimizer の結果